Google TPU 8tx ve 8i Max: Yapay zekâ için güvenlik ve bellek odağı
Donanım
Görüntüleme: 3
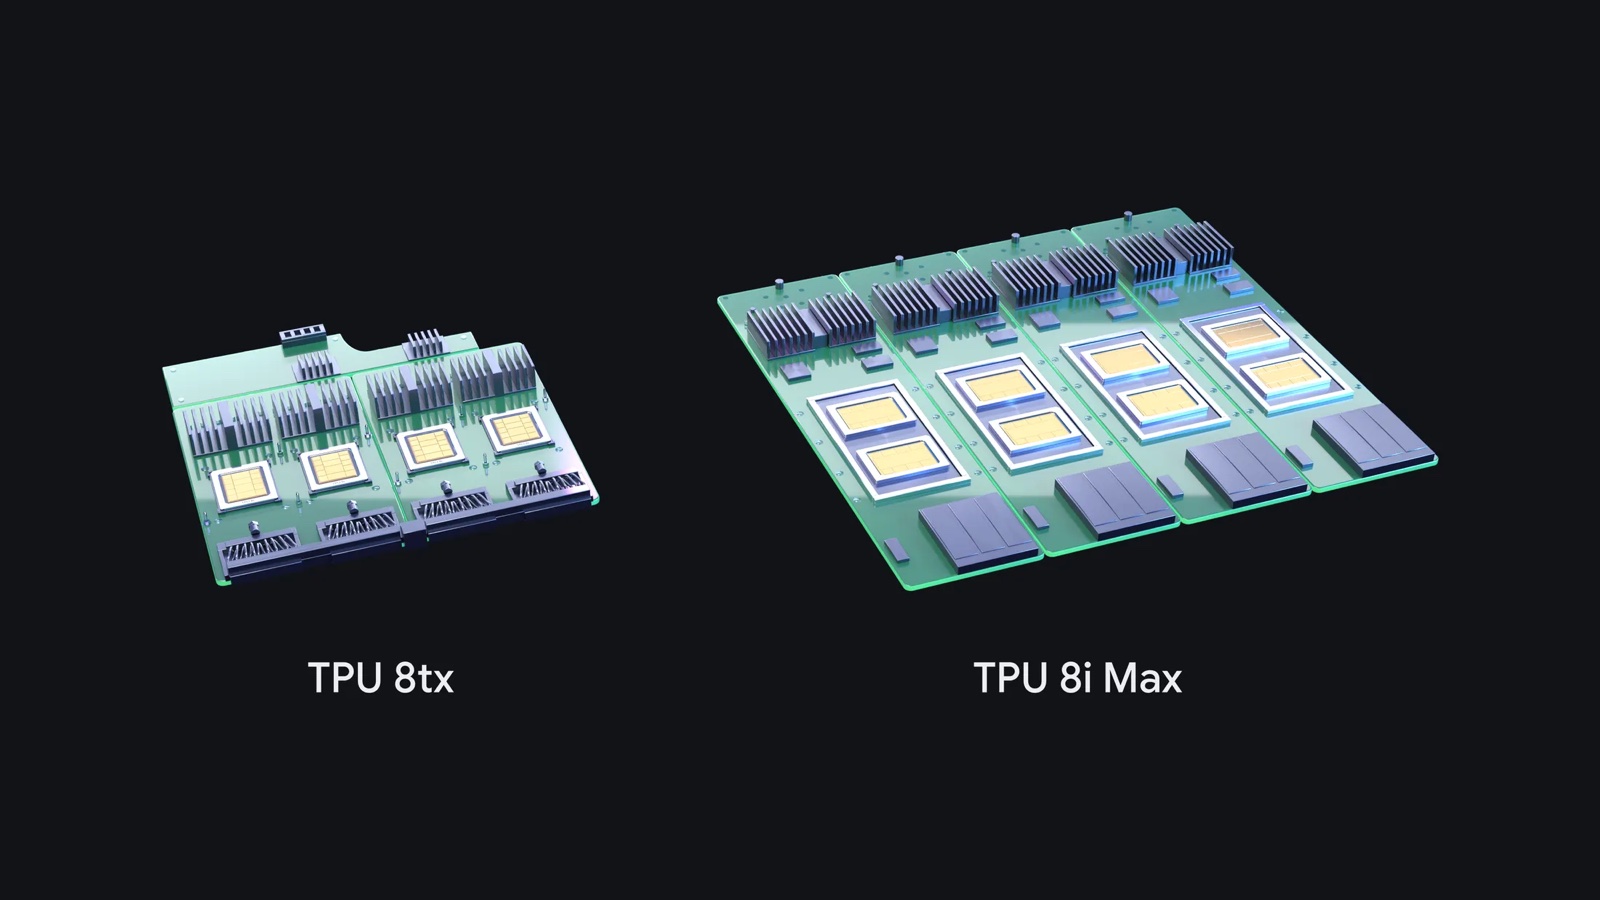
Google, yapay zekâ için geliştirdiği sekizinci nesil TPU ailesine iki yeni sistem ekledi: TPU 8tx ve TPU 8i Max. 9 Kasım’da duyurulan modellerden 8tx hassas verilerin işlendiği güvenli yapay zekâ uygulamalarına, 8i Max ise çok uzun bağlamlarla çalışan ajanların bellek ve işlem gücü ihtiyacına odaklanıyor. Böylece şirket, aynı yıl içinde dört ayrı sekizinci nesil TPU sistemi duyurmuş oldu.
İki yeni sistem, farklı ihtiyaçlar
TPU, Google’ın yapay zekâ hesaplamaları için tasarladığı hızlandırıcı ailesi. İlk örnekler on yılı aşkın süre önce ses tanıma ve dil çevirisi gibi şirket içi ihtiyaçlar için geliştirilmişti. Bugün Gemini modellerinin eğitimi ve çalıştırılması, yapay zekâ ajanları, Google Cloud müşterilerinin uygulamaları ve müşterilerin kendi veri merkezlerinde TPU kullanması bu kapsamda yer alıyor. Google, araştırma laboratuvarları, finans kuruluşları, perakendeciler ve üniversiteler dahil müşteri sayısının yaklaşık 100’e ulaştığını belirtiyor.
Nisan ayındaki Google Cloud Next etkinliğinde tanıtılan TPU 8t büyük ölçekli model eğitimine, TPU 8i gerçek zamanlı akıl yürütmeye yönelikti. Şirket, önceki nesle kıyasla 8t için 2,7 kata kadar eğitim performansı, 8i için yüzde 80 daha iyi çıkarım fiyat-performansı açıklamıştı. Google ayrıca 8t’nin enerji başına yararlı işi artırmaya, 8i’nin ise çipler arası iletişim gecikmesini yarıya kadar azaltarak bellek darboğazını hafifletmeye odaklandığını belirtiyor. Bu karşılaştırmalar Google’ın kendi beyanları; her uygulamada aynı sonucu garanti etmiyor.
Yeni duyuruda özellikle “çip” ile “sistem” ayrımı yapılıyor. Yeni bir silikon tasarımı yıllar sürebilirken mevcut çiplerin paketleme, bellek, ağ ve güvenlik bileşenleriyle farklı biçimde bir araya getirilmesi daha kısa sürede yeni kullanım alanlarına uyarlanabiliyor. Google, AI Hypercomputer mimarisindeki modüler yaklaşımın bu esnekliği sağladığını söylüyor.
TPU 8tx: Veri kullanımdayken de koruma
TPU 8tx, TPU 8t ile aynı silikon temelini kullanıyor ve beşinci nesil AMD EPYC ana işlemcilerle eşleştiriliyor. Sistem, düzenlemelere tabi kuruluşlar ve kamu kurumları başta olmak üzere, özel modellerini hassas verilerle birlikte çalıştıran müşteriler için tasarlandı. Verinin yalnız depolanırken ya da ağ üzerinden aktarılırken değil, işlem sırasında da donanım düzeyinde korunması ve yalıtılması hedefleniyor.
Google, gerçek zamanlı akıl yürütme için geliştirdiği düşük gecikmeli Boardfly ağını burada da kullanıyor. Şirketin açıklamasına göre TPU 8t ile karşılaştırıldığında gecikme yarıya kadar düşürülebiliyor ve güvenlik katmanının performans kaybı sıfıra yakın tutuluyor. Duyurudaki bu oranlar üreticinin karşılaştırması olarak değerlendirilmeli.
8tx yalnız çıkarım için değil, küçük ölçekli eğitim için de kullanılabiliyor. Kuruluşlar özel verileriyle ince ayar yapabiliyor, büyük modelleri daha küçük modellere damıtabiliyor ve ajanlarını pekiştirmeli öğrenmeyle eğitebiliyor. Böylece hassas verilerin ayrı eğitim ve çıkarım kümeleri arasında taşınma ihtiyacı azaltılıyor.
TPU 8i Max: Aynı pakette iki çip
TPU 8i Max, iki düşük gecikmeli TPU 8i çipini tek pakette birleştiriyor. Google’a göre bu düzenleme, 8i’ye kıyasla işlem gücünü, SRAM kapasitesini ve yüksek bant genişlikli bellek olan HBM’nin bant genişliğini ikiye katlıyor. Amaç, çok sayıda ajanın geniş bir yazılım deposu ya da saatlerce video üzerinde çalıştığı durumlarda işlemcinin veri beklemesini azaltmak.
Mevcut raf alanına daha fazla silikon yerleştirilmesi, veri merkezinde birim alan başına işlem yoğunluğunu yükseltiyor. Google ayrıca watt başına daha fazla hesaplama gücü hedeflediğini belirtiyor. Ancak iki kat bileşen kapasitesi, bütün uygulamaların otomatik olarak iki kat hızlanacağı anlamına gelmiyor; yazılımın ve iş yükünün özellikleri belirleyici olmaya devam ediyor.
Yazılım tarafında altı başlık
Donanım duyurusuna açık yazılım araçları da eşlik ediyor. Geçen ay açık kaynak haline getirilen TorchTPU, PyTorch kodlarının ve Hugging Face modellerinin TPU’larda yerel çalışmasını sağlıyor. vLLM ve SGLang gibi çıkarım motorları için hazır arka uçlar sunuluyor. Önizlemedeki açık kaynak TPU agent suite ise Claude Code, Cursor ve Google Antigravity gibi kodlama araçlarına bağlanarak kurulum, darboğaz teşhisi ve özel çekirdeklerin ayarlanmasına yardımcı oluyor. Yeni XLA Serving Engine, Python’da eğitilen modelleri TPU, GPU ve CPU üzerinde düşük gecikmeli C++ çalışma ortamında sunmaya yönelik.
Google, InferenceX ve AgentX karşılaştırmalarında yerel vLLM–TorchTPU yığınının güçlü fiyat-performans sonuçları verdiğini bildiriyor. Şirketin işaret ettiği ölçümler, teorik tepe hızları yerine ajan tabanlı kodlama ve uzun bağlam gibi iş yüklerine odaklanıyor; sonuçların model ve sunum yazılımıyla birlikte okunması gerekiyor.
Agent Compute Engine, bir veritabanı sorgusunu, harici aracı veya insan yanıtını bekleyen ajan oturumlarını askıya alıp çalışma belleğini milisaniyeler içinde çipten çıkarabiliyor. Böylece bekleme sırasında atıl kalan hesaplama kaynaklarının maliyetinin azaltılması amaçlanıyor.
Açık kaynak olarak sunulan TPU Sync; çip üzerindeki HBM’yi, ana sistem DRAM’ini, ortak depolamayı ve veri merkezi ağını birlikte yöneten model durumu katmanı. Büyük KV önbelleklerini kademelendiriyor, bağlamı ayrı ön işleme ve üretim düğümleri arasında taşıyor ve pekiştirmeli öğrenme ağırlıklarını eşitliyor. Google, KV aktarım gecikmesi ile ilk çıktının gelme süresinde yüzde 90’dan fazla azalma bildirse de bu oran belirli koşullardaki şirket ölçümünü yansıtıyor.
Google Kubernetes Engine üzerinde genel kullanıma açılan Cloud Pathways, Gemini’nin arkasındaki dağıtık çalışma yaklaşımını bulut müşterilerine taşıyor. Tek denetleyici ve pathwaysutils ile birden fazla TPU dilimi yerel bir makine gibi yönetilebiliyor; Python yan süreçleri, bir dakikadan kısa süren dilim değişimleri ve esnek yeniden bölümlendirme uzun işleri donanım kesintilerine karşı destekliyor.
Genel kullanıma açılan GKE dynamic slicing ise optik devre anahtarlamayı kullanarak TPU küplerini büyük topolojilerde birleştiriyor veya daha küçük, yalıtılmış işlere bölüyor. Google, iş başlatmanın beş kata, hata sonrası toparlanmanın 4,5 kata kadar hızlandırılabildiğini belirtiyor. Böylece donanım tahsisi ile mantıksal iş bölümü arasındaki katı bağlantının azaltılması hedefleniyor.
Dört modelin görev dağılımı
Yeni ailede 8t büyük ölçekli eğitim, 8i düşük gecikmeli akıl yürütme, 8tx gizli hesaplama, 8i Max ise büyük bağlam ve yüksek raf yoğunluğu için konumlanıyor. Google; silikon, ağ, derleyici ve DeepMind ekiplerinin birlikte çalıştığını, AlphaChip ve Gemini’den yeni donanım tasarımında da yararlandığını açıklıyor. Duyuru, şirketlerin tek bir hızlandırıcı seçmekten çok veri güvenliği, bellek ihtiyacı ve yazılım altyapısını birlikte değerlendireceği bir ürün yaklaşımını gösteriyor.
Kaynak: Google, 9 Kasım 2026.
Dji Banner Inside Article - 728x90